
Jev, el nuevo modelo de inteligencia artificial de TypeSafe AI, nace con una ambición difícil: conseguir que la IA deje de ser brillante conversando y empiece a ser realmente fiable trabajando. Los modelos actuales conversan mejor que casi cualquier humano, pero la automatización real sigue atascada en demos que solo funcionan algunas veces.
TypeSafe AI es una pequeña empresa de San Francisco, que salió del sigilo el 15 de septiembre de 2026, con 40 millones de dólares de financiación en una ronda liderada por DCVC, según informó Forbes.
Jev es una inteligencia artificial que entiende el lenguaje, pero jamás escribe una palabra. Tú le entregas una situación en texto y una lista cerrada de respuestas posibles, y ella devuelve la decisión marcada con su nivel de confianza, todo en décimas de segundo. TypeSafe la presenta como el primer System One Model, un homenaje al pensamiento rápido e intuitivo que describió Daniel Kahneman, y promete latencias de 70 a 500 milisegundos con un precio de 0,042 dólares por millón de unidades de texto (tokens) de entrada, según sus propios datos.
¿Qué es Jev y por qué no es un chatbot más?
Si esa promesa se sostiene fuera del laboratorio, el cambio es enorme porque el coste de decidir se desploma y millones de decisiones pequeñas que hoy salen caras con un gran modelo de lenguaje pasarían a costar fracciones de céntimo. ¿Lo mejor? Jev ya está disponible para todos hoy, y pese a que sus cifras más agresivas vienen de evaluaciones diseñadas por la propia empresa, la realidad es que este modelo lo está cambiando todo en el mundo de la IA.
Piensa en la diferencia entre un camarero que conversa y una máquina expendedora que entrega. Los modelos como GPT-5.6 o Claude son camareros que redactan respuestas palabra a palabra y a veces se inventan el plato (o todo el menú completo). Jev es lo contrario, es una expendedora inteligente que entiende lo que le describes y devuelve una decisión válida con su probabilidad, sin redactar nada. Y allí la magia: Jev no te marea con grandilocuencia, simplemente te da una respuesta según los parametros que has indicad, eso y nada más.
La idea de Jev nace en TypeSafe AI, una empresa que tiene su origen en San Francisco en 2024 de la mano de Diogo Almeida junto a Erik Gafni y Sasha Sheng, tras unos cuatro años de Almeida en OpenAI trabajando en el aprendizaje por refuerzo con opinión humana que dio forma a InstructGPT y ChatGPT, según cuentan Forbes y TechCrunch.
La Paradoja de Jevons
Después de casi dos años de trabajo en silencio, la empresa presentó a Jev como su primer modelo público y abrió una lista de espera para probarlo, con una ronda semilla de 40 millones liderada por DCVC que valora la compañía en unos 200 millones.
Ahora, el nombre de Jev te parecerá una broma de mal gusto, pero tiene su encanto y su propia historia. El nombre rinde homenaje al economista William Stanley Jevons y su paradoja (la Paradoja de Jevons), que dice que cuando un recurso se abarata se consume mucho más, mientras la etiqueta System One viene del Sistema 1 de Daniel Kahneman, el modo mental rápido e intuitivo.
La apuesta de Almeida es que el software necesita justo eso, respuestas rápidas y fiables en lugar de charla brillante, porque un programa no quiere conversar sino decidir qué hacer con cada dato que recibe.
La computación cuántica industrial se cita en Burgos el 14 y 15 de octubre
Y ¿Cómo funciona Jev?
La clave está en el formato de la petición, que siempre tiene dos piezas. Tú envías un bloque de contexto con la situación en texto libre y un conjunto de preguntas con respuestas cerradas, y Jev evalúa todas las preguntas de una sola vez contra ese contexto.
Si gestionas soporte, el contexto puede ser el historial de un cliente y las preguntas la categoría del caso y su urgencia de cero a cien, y la respuesta llega como valores tipados con probabilidad, sin texto que interpretar ni validar.
{
  "model": "jev-latest",
  "state": "El cliente escribió dos veces por un reembolso fallido...",
  "questions": {
    "categoria": {"type": "choice", "options": ["facturacion", "soporte", "ventas"]},
    "urgencia": {"type": "score", "min": 0, "max": 100}
  }
}
El catálogo de preguntas tiene tres piezas que cubren casi todo. Choice elige una opción dentro de un conjunto definido, como clasificar un ticket entre facturación, soporte técnico, ventas o spam. Score puntúa el contexto en niveles ordenados, como la probabilidad de fuga.
Noul responde sí o no con una probabilidad entre cero y uno, como decidir si un mensaje viola una política, y cada respuesta trae su confianza porque el esquema define de antemano todos los valores válidos, según la documentación oficial.
Más allá de los LLMs generales
El problema es que los modelos de lenguaje (LLMs o IAs como las conocemos) escriben como quien dicta una frase palabra a palabra, con cada fragmento condicionado por el anterior, lo que encarece y alarga cada respuesta cuando solo necesitas una decisión.
En el caso de Jev, este rellena todo el formulario de golpe en una sola pasada paralela sobre el hardware, y por eso TypeSafe informa latencias de 70 a 500 milisegundos frente a los 3 a 329 segundos que un comparador independiente midió en modelos frontera.
El entrenamiento también cambia de objetivo con un método llamado aprendizaje por refuerzo para decisiones calibradas. Mientras el ajuste con opinión humana premia respuestas que gustan y el de recompensas verificables premia soluciones comprobables, este método premia la honestidad numérica, que un 70 por ciento de confianza acierte unas siete de cada diez veces, como un termómetro bien ajustado.
¿En qué se diferencia de los LLM a los que estás acostumbrado?
Como los valores válidos se declaran antes de la llamada, el modelo no puede devolver nada fuera del esquema ni cometer errores de tipo, y TypeSafe sostiene que la alucinación en sentido de formato queda eliminada por construcción.
La calibración permite además fijar un umbral y actuar en automático por encima de él mientras los casos dudosos se derivan a una persona o a un modelo mayor, que es justo lo que piden los flujos desatendidos.
5 alternativas gratuitas de software a la suite de Adobe en 2026
La comparación honesta no es qué modelo es más listo en abstracto, sino qué pieza resuelve cada trabajo. Un gran modelo de lenguaje genera texto abierto que luego hay que interpretar y validar, con riesgo de que invente datos o desobedezca el formato.
En su lugar, Jev devuelve valores cerrados que el programa consume sin intermediarios, y esa renuncia al texto es la que compra velocidad y precio, según la comparativa técnica que publicó DataCamp tras el lanzamiento.
| Aspecto | Modelo de lenguaje frontera | Jev de TypeSafe |
|---|---|---|
| Salida | Texto libre que hay que interpretar | Valores cerrados listos para el código |
| Muestreo | Palabra a palabra en secuencia | Todo de golpe en una pasada |
| Precio de entrada | De 0,20 a 10 dólares por millón | 0,042 dólares por millón |
| Precio de salida | Hasta cinco veces la entrada | Gratis por barata de medir |
| Latencia | De segundos a minutos | De 70 a 500 milisegundos |
| Confianza | Segura aunque dude | Probabilidad ajustada a su acierto |
| Fallo típico | Inventa datos o rompe el formato | Elige mal dentro de lo permitido |
0,042 dólares por millón
Los números que da TypeSafe marcan la distancia. La entrada cuesta 0,042 dólares por millón frente a una horquilla de 0,20 a 10 dólares en modelos frontera, la salida sale gratis por barata de medir y la latencia de 70 a 500 milisegundos deja atrás los segundos habituales.
En sus cuatro flujos de prueba internos, Jev iguala a GPT-5.6 Terra con 67,8 por ciento frente a 67,9, por debajo de Sol con 74,1 y Opus 5 con 73,1, con un coste por caso de 0,0004 dólares, según DataCamp.
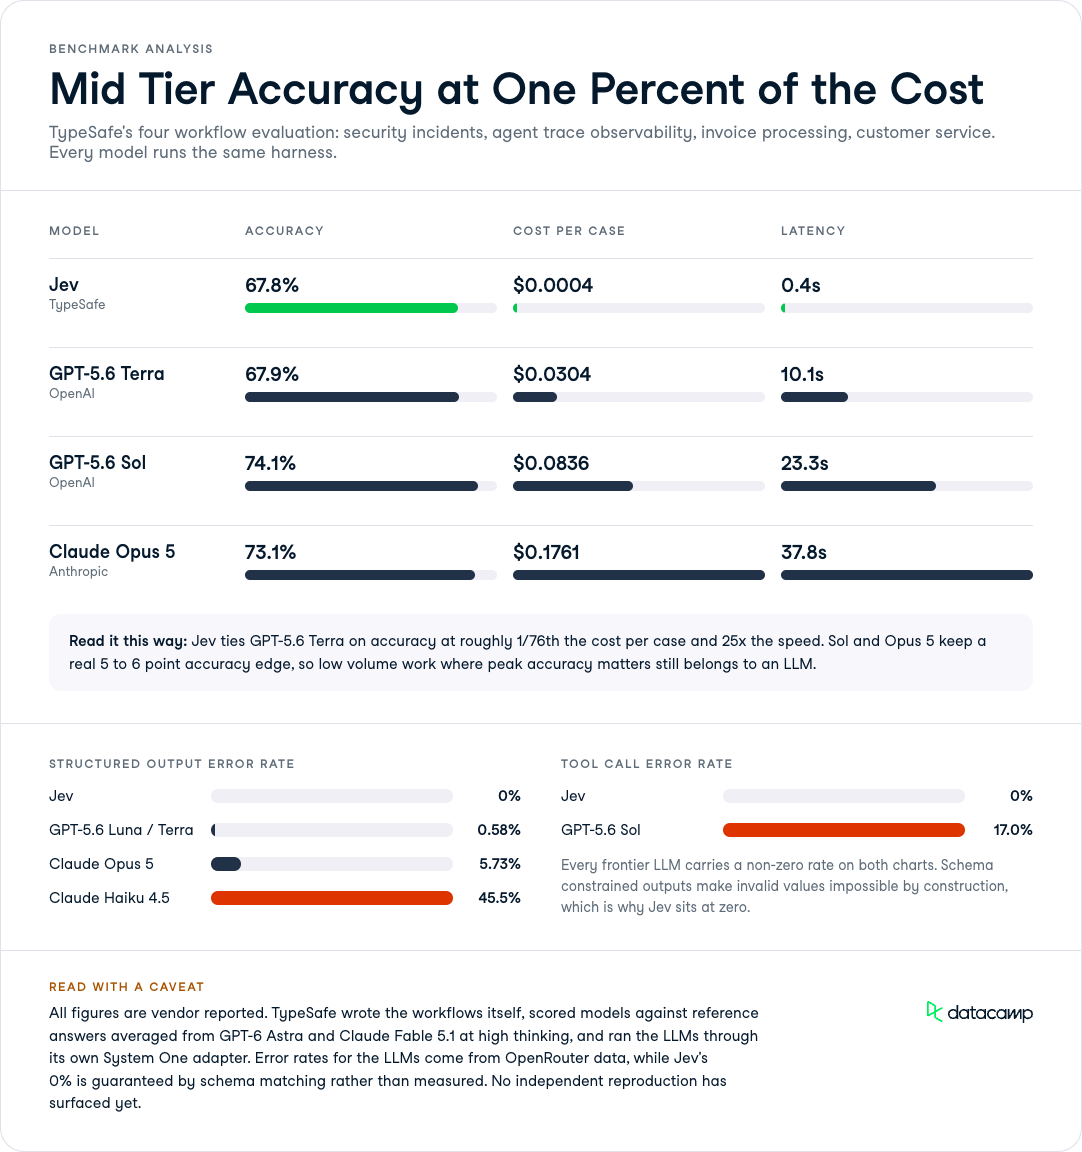
Esa foto deja un trueque claro para quien diseña sistemas. Los modelos punteros conservan de cinco a seis puntos de precisión en tareas de poco volumen donde cada acierto vale oro, mientras Jev se queda con el volumen donde el céntimo manda. Ninguno jubila al otro, y el acierto está en repartir el trabajo entre ambos.
¿Para qué sirve una IA que solo sabe decidir?
En fiabilidad de formato, Jev declara cero errores por construcción frente a 0,58 por ciento de los modelos pequeños de OpenAI, 5,73 de Opus 5 y un llamativo 45,5 de Haiku 4.5, con Sol en 17 por ciento de fallos en llamadas a herramientas.
Un error de formato entierra un flujo desatendido a las tres de la mañana, y por eso la garantía de esquema pesa tanto como la velocidad para equipos que automatizan en serio cada noche.
Vitalik rechaza el pesimismo y ve en la IA una aliada de la ciberseguridad
Jev brilla donde la decisión se repite millones de veces con respuestas conocidas de antemano. Clasificar y rutear tickets, puntuar clientes, extraer campos de facturas, vigilar respuestas de otros modelos y detectar jailbreaks son trabajos de ese tipo, y TypeSafe los resume como sentencias if difusas que el código usa sin miedo.
Vigilancia de los propios modelos de lenguaje
Tienes SDK oficiales para Python y JavaScript que te permiten declarar el esquema y llamar a la API alojada, lo que te facilita integrarlo en minutos en flujos que ya existen en tu empresa.
Otro encaje natural es la vigilancia de los propios modelos de lenguaje, con Jev como juez que puntúa cada respuesta, detecta fugas de datos y frena usos indebidos antes de que lleguen al usuario.
Como ese control se ejecuta en cada llamada, la latencia de décimas y el coste por caso de 0,0004 dólares lo hacen viable donde un juez grande arruinaría el presupuesto del equipo cada mes.
La puerta a sistemas interactivos en tiempo real
La velocidad abre además la puerta al tiempo real, donde un gran modelo no llega. TypeSafe mostró a Jev jugando a Doom al reaccionar al estado del juego unas diez veces por segundo con un coste aproximado de siete dólares por hora, y resolviendo Wikiracing al elegir entre cientos de enlaces sin inventarse ninguno.
Un bot programado a mano jugaría mejor, pero la gracia es que Jev decide con inteligencia ante estados que nunca vio, algo que el código rígido no sabe hacer cuando el contexto cambia.
El precio ridículo por decisión permite además barrer datos gigantes que con un modelo frontera saldrían carísimos. Puntuar los 50 millones de reseñas de una tienda para sentimiento y violaciones de política costaría unos 20 dólares al ritmo declarado, frente a miles con un gran modelo.
En la práctica, ambos mundos se combinan, con Jev como capa rápida que clasifica y deriva y un modelo grande para los pocos casos difíciles que piden explicación escrita y criterio humano abierto.
¿Qué conviene mirar con lupa antes de celebrarlo?
Casi todas las cifras espectaculares vienen de la propia TypeSafe y aún no tienen réplica independiente. Los cuatro flujos los escribió su equipo de capacidades y las respuestas de referencia promedian dos modelos concretos de OpenAI y Anthropic.
La propia empresa admite que los picos de 193,6 veces más rápido y 444,6 veces más barato están en el extremo alto de lo esperable. El análisis independiente de TrueFoundry insiste en leer la paridad de inteligencia como prometedora y no como cerrada.
Hay un matiz conceptual que conviene no perder. Jev no puede inventarse un campo ni devolver un formato inválido, pero sí puede elegir la categoría permitida equivocada con confianza alta, y eso es un error de juicio y no de formato.
Jev no genera texto ni explicaciones
La respuesta de TypeSafe a ese riesgo es la calibración, justo la propiedad que ningún laboratorio externo ha verificado todavía, y el modelo llega además como API propietaria sin pesos ni documento técnico.
Existen límites prácticos que el lanzamiento reconoce. Cada pregunta de elección acepta hasta 255 opciones y por encima hay un sistema en dos fases que puntúa y luego elige, con algo menos de velocidad.
Jev no genera texto ni explicaciones, así que un equipo regulado que deba justificar por qué denegó una solicitud tendrá que derivar esos casos a un modelo que redacte el motivo y deje rastro auditable.
Computación biológica: Singapur prueba 20 ordenadores con neuronas humanas
Lo que Jev cambia en la economía de la inteligencia
De esta manera, la jugada de TypeSafe apunta a la economía más que al ingenio, porque cada orden de magnitud que cae el coste de decidir abre usos que antes no salían a cuenta.
La paradoja de Jevons dice que la máquina de vapor eficiente disparó el consumo de carbón, y Almeida espera lo mismo de la inteligencia barata, una difusión continua de decisiones automáticas por cada rincón del software.
El problema es que nadie ha comprobado fuera de TypeSafe si la calibración aguanta en manos ajenas ni si el precio de 0,042 dólares sobrevivirá sin subvención cuando la lista de espera se abra del todo.
Si ambas respuestas salen afirmativas, los equipos dejarán de preguntar qué modelo usan y pasarán a decidir qué tarea merece cada tipo de modelo, con una capa de orquestación estable siempre por delante.