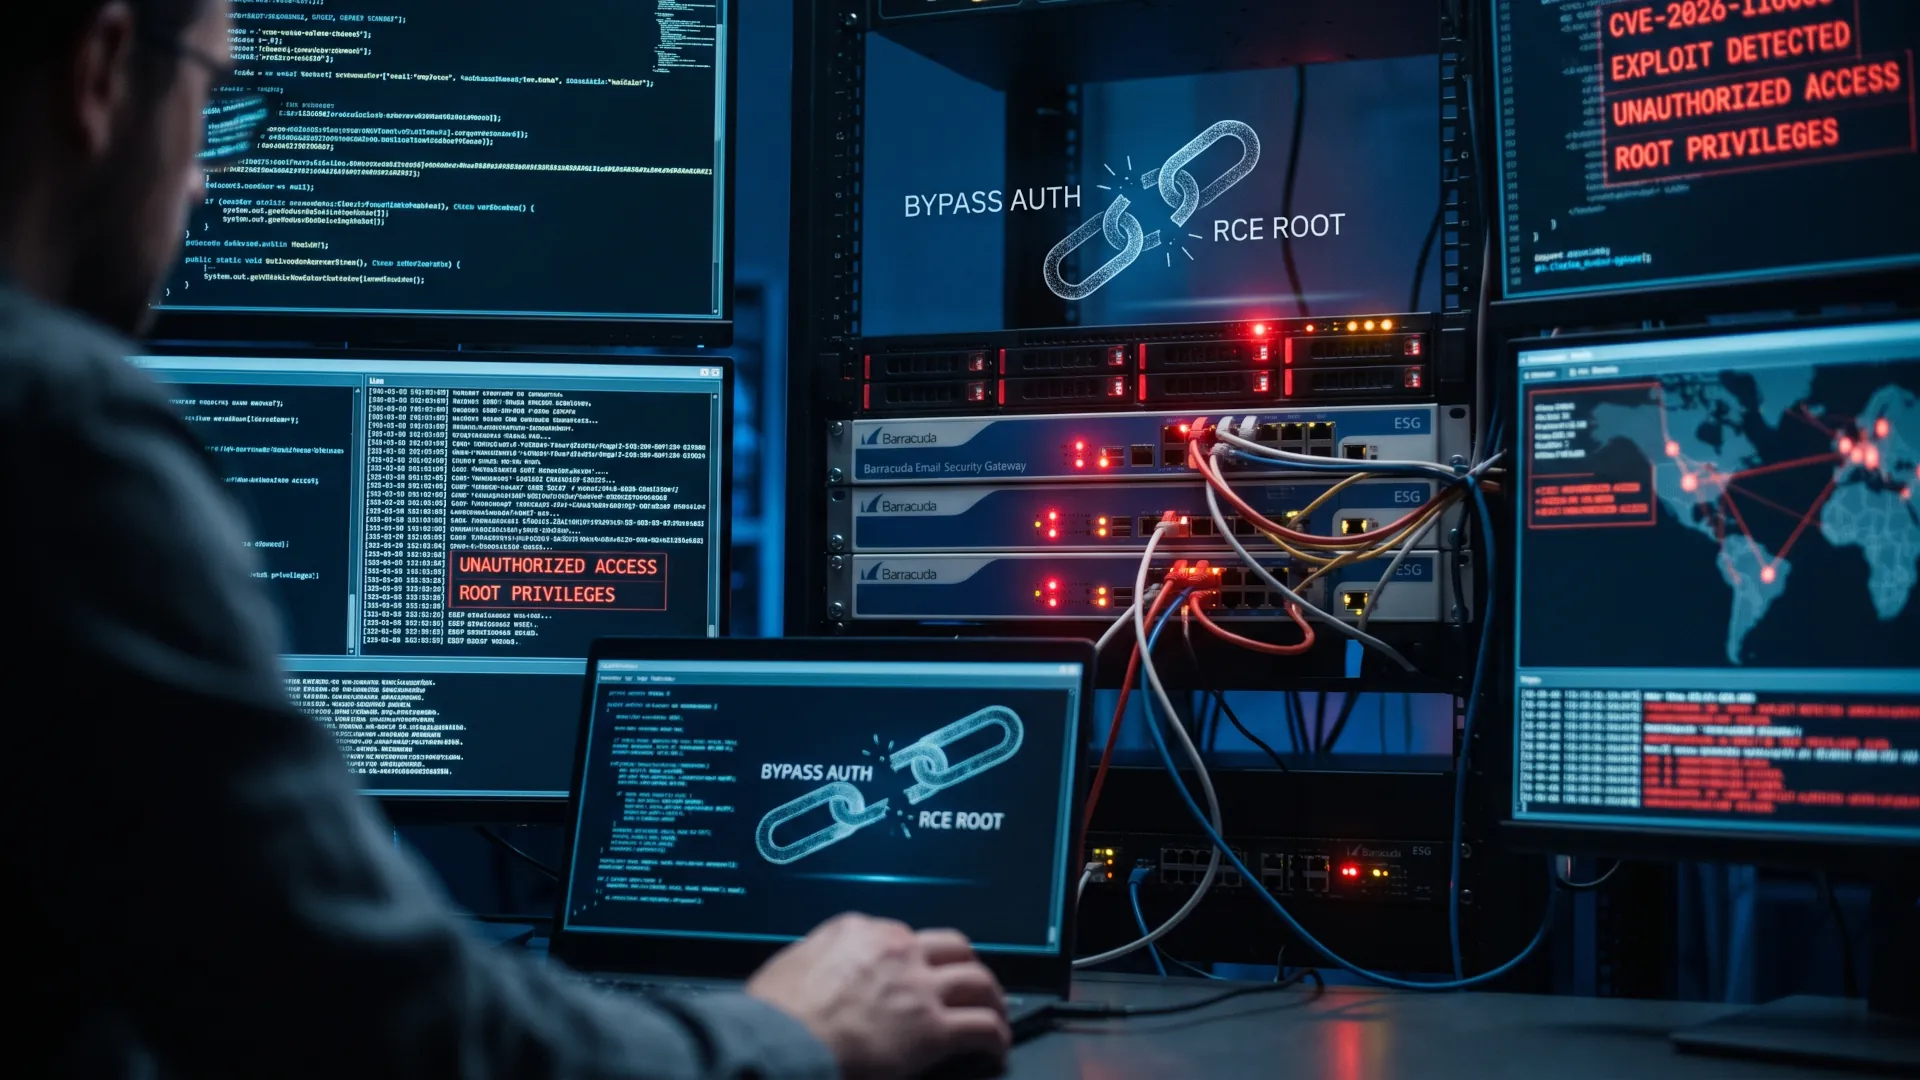
Sin credenciales a root en tu filtro de correo: la alerta del 16 de noviembre de 2026 describe cómo un atacante encadena CVE-2026-116606 (9,8) y CVE-2026-111560 (7,2) en Barracuda ESG para pasar de la interfaz de administración a root sin robar una contraseña. Los dos afectan a productos de Barracuda Networks, los dos tienen exploit público y los dos se están usando.
La alerta sobre el CVE-2026-116606 en el ESG de Barracuda detalla la gravedad de cada pieza. CVE-2026-116606 tiene una puntuación de 9,8 sobre 10 y permite a un atacante no autenticado eludir los controles de autorización. CVE-2026-111560 puntúa 7,2 y permite ejecutar comandos del sistema con privilegios de root, aunque exige acceso administrativo previo.
El interés está en la combinación. El primero abre la puerta de la interfaz de administración sin credenciales; el segundo convierte ese acceso en control total del equipo. Un atacante que encadene ambos pasa de estar fuera a ser root sin haber robado una contraseña, y ese es el tipo de cadena que convierte una vulnerabilidad molesta en un incidente de seguridad con mayúsculas. La pregunta ya no es si hay parche, es cuántos paneles siguen expuestos mientras se instala.
¿Qué productos están afectados?
La lista de equipos afectados es más ancha de lo que sugiere el nombre del producto. Incluye Email Security Gateway, ADC / Load Balancer, Message Archiver, WAF, WAF Control Center y Web Security Gateway. Todos comparten la misma interfaz de administración y, por tanto, la misma puerta de entrada.
La recomendación oficial es actualizar a la última versión disponible. Cuando eso no es posible de inmediato, el consejo es restrictivo y sensato: limitar el acceso a la interfaz de administración a redes internas de confianza y usar controles de acceso a la red para reducir la exposición. En la práctica, eso significa dejar de tener el panel de administración visible desde internet, que es justo lo que casi nadie hace cuando administra desde casa.
La restricción no es cosmética. Un panel expuesto recibe intentos de autenticación de todo el mundo cada día, y la diferencia entre un intento y una intrusión es una cadena como esta.
Ninguna de las dos medidas es nueva ni exótica. Ambas aparecen en cualquier guía de configuración segura desde hace una década, y ambas se saltan con la misma frecuencia por comodidad operativa. El problema de fondo es que una pasarela de correo suele administrarse desde cualquier sitio, porque quien la mantiene no siempre está en la misma oficina que el equipo.
El papel de una pasarela de correo
Un filtro de correo no es un servicio periférico. Es la puerta por la que entra la mayoría del contenido que una empresa recibe del exterior, y también el punto donde se guardan las credenciales de integración con el resto del ecosistema. Si alguien obtiene root ahí, hereda la posición privilegiada del aparato: lee el correo que pasa, modifica reglas, añade remitentes de confianza y se coloca en el centro de la cadena.
Ese efecto es el mismo que se vio con la cadena de fallos que comprometió miles de equipos corporativos a principios de noviembre: el valor del equipo atacado no está en sus datos, está en su posición. Los dispositivos que hacen de intermediarios entre empleados y servicios externos son los objetivos más rentables porque nunca se revisan como se revisa un servidor de producción.
El calendario tampoco ayuda. La alerta llega dos semanas después del Patch Tuesday de noviembre, con 1.094 vulnerabilidades corregidas por Microsoft, y los equipos de seguridad están procesando esa cola. Cuando todos los proveedores publican a la vez, lo que se retrasa no es el parche difícil, es el de la aplicación secundaria que nadie recuerda tener.
La cadena como patrón de 2026
Este año ha dejado de sorprender que las cadenas de explotación sean la norma y no la excepción. Un fallo aporta el acceso inicial, otro hace la escalada, y el trabajo artesanal se concentra en unir las piezas. El resultado es que dos vulnerabilidades de gravedad media pueden producir un incidente crítico, y las clasificaciones individuales no lo reflejan.
El caso del error de OpenSSH que puso en jaque a Linux y musl mostró la variante más incómoda: un fallo que se anunció como limitado y que, en combinación con otras condiciones, cambiaba de categoría. Clasificar un fallo de forma aislada sirve para priorizar parches, no para predecir el riesgo real de una infraestructura concreta.
Para el responsable de seguridad, la consecuencia es incómoda. Las métricas de severidad ayudan a decidir qué se parchea primero, pero no a decidir qué se revisa de verdad. Un equipo que solo mira la puntuación de 10 margen el 7,2 que tenía detrás, y ese es exactamente el que cierra la cadena.
¿Qué hacer? Aislar el panel, parchear y buscar persistencia
Lo primero es saber si el producto está en la lista y, sobre todo, si su panel de administración es accesible desde internet. Un inventario de interfaces expuestas resuelve más incidentes que cualquier herramienta de detección de última generación, y se hace en una tarde con una hoja de cálculo y un escaneo.
Lo segundo es actualizar con criterio. Los parches de emergencia a veces rompen funcionalidad, y la tentación de esperar al fin de semana siguiente es humana. En este caso hay dos agravantes: exploit público y explotación en curso, lo que reduce el margen de negociación a horas o días, no a semanas.
Lo tercero es revisar la evidencia. Si un atacante consiguió root en una pasarela de correo, dejó rastro en reglas de transporte, cuentas de servicio y registros de autenticación. Buscar solo el archivo malicioso sirve para cerrar el ticket, no para saber si el acceso sigue vivo.
La revisión debe incluir cuentas creadas, reglas nuevas y cambios en las listas de confianza. Un atacante que llega a root no necesita volver a entrar si deja una puerta abierta con su nombre dentro.
Lo que este incidente dice del modelo
Un fabricante de seguridad cuyos productos se usan para protegerse es, por definición, un objetivo apetitoso. Los atacantes lo saben y lo explotan: cada fallo gana valor, y cada exploit publicado degrada la confianza en toda la marca. No es casualidad que las alertas de este mes se acumulen en torno a herramientas que ocupan posiciones privilegiadas en la red corporativa.
Lo que cambia con el tiempo es la velocidad. La explotación activa y la prueba de concepto pública llegan casi juntas, y el tiempo entre la publicación y el primer ataque se mide ya en horas. Un modelo de gestión que asume días de margen está desfasado por definición.
La lectura útil para el lector es una sola. Los equipos que se compran por la etiqueta de seguridad y se instalan en un rincón de la red son los que acaban en las listas de incidentes, porque nadie los mira hasta que el fabricante avisa. Si expones el panel de administración a internet: restríngelo hoy, parchea en 48 horas y revisa cuentas, reglas y registros de autenticación.