Superfluid, un harness IA que rompe todos los records de velocidad
Superfluid es un servidor local de código abierto que reparte un mismo modelo entre varios agentes, con APIs compatibles con OpenAI, Anthropic y Ollama.
Superfluid, el software libre que sirve LLM a varios agentes
Pedirle a un modelo local que haga una cosa mientras hace otras siete al mismo tiempo, no funciona bien en la mayoría de montajes caseros. Por ello, la realidad es que el agente que resume tus correos por la noche se queda con el control de la máquina, y cuando tú escribes en el chat tu pregunta, en realidad esperas detrás de todo lo que ya está en cola. Para solucionar esto, Basecompute publicó en HuggingFace, ahora en manos de NVIDIA, una herramienta que ataca exactamente ese problema, y lo hizo con un número incómodo en la mano.
Con ocho agentes procesando documentos, una pregunta de chat lanzada a los dos segundos recibió su primer token en 1,5 segundos con Superfluid. El mismo modelo y la misma máquina, pero a través de llama-server, tardaron 291 segundos. La diferencia no está en el motor de inferencia, que es el mismo en ambos casos: está en la capa que decide a quién le toca hablar, y es simple cambio, tiene un gran impacto.
Superfluid y su propuesta: velocidad y multitarea agéntica
El benchmark que acompaña al anuncio es del propio fabricante, así que hay que leerlo como una medición interesada pero con metodología publicada. Se ejecutó en un Apple M5 Pro con el modelo Qwen3.8-27B cuantizado a 4 bits, y cada servidor usaba el mismo motor de inferencia, de modo que la comparación aísla la capa de servicio.
Medición
Superfluid
llama-server
Ollama
mlx_lm.server
Primer token para un chat detrás de 8 agentes
1,5 s
291 s
380 s
612 s
Aciertos de caché con 32 peticiones que comparten un prompt de 4k tokens
97%
75%
97%
0%
Recuperación al matar el worker a mitad de stream
1,8 s
no aplica
1,8 s, stream truncado
no aplica
La primera fila es la que justifica el proyecto. Los 291 segundos de llama-server y los 380 de Ollama no son un fallo de rendimiento, son simplemente el resultado de atender en orden de llegada.
Si ocho agentes han pedido trabajo antes que tú, tu pregunta es la novena tarea que tienen que hacer. La cola de Ollama, además, no tiene forma de saber que tu petición viene de una persona y no de un proceso programado. No hay una línea de control y definición de prioridades, y eso tiene un coste.
La tercera fila merece su propio comentario. Cuando se mata el worker de inferencia a mitad de una respuesta, Superfluid devuelve el servicio en 1,8 segundos y la sesión continúa. Ollama también tarda 1,8 segundos, pero el stream llega truncado, lo que significa que quien estuviera leyendo la respuesta pierde el final sin enterarse. llama-server y mlx_lm.server no cubren ese escenario en la comparativa.
¿Cómo se mide y por qué importa el método?
Basecompute publicó el harness con el que hizo las mediciones dentro del propio repositorio, bajo el nombre superfluid/tools/suite, y las cifras completas con su metodología en la web del proyecto. Esa decisión merece reconocimiento porque permite repetir la comparación en otra máquina en lugar de creerla.
El escenario medido está descrito con precisión: ocho agentes trabajando en paralelo sobre documentos de 7.500 tokens y una pregunta de chat que entra cuando el sistema ya lleva dos segundos ocupado. Todas las opciones comparadas usan el mismo motor de inferencia, de modo que la única variable que cambia es la capa que reparte el trabajo. Sin esa igualdad de condiciones, la comparación no diría nada.
El detalle del preemption explica el resto. La petición interactiva no se cuela a la fuerza en mitad de un lote: espera al siguiente tick del planificador y toma el turno antes que el trabajo por lotes. Ese matiz es la diferencia entre un sistema predecible y uno que interrumpe cálculos a medias para atender al usuario.
Un servidor, tres APIs y tres motores
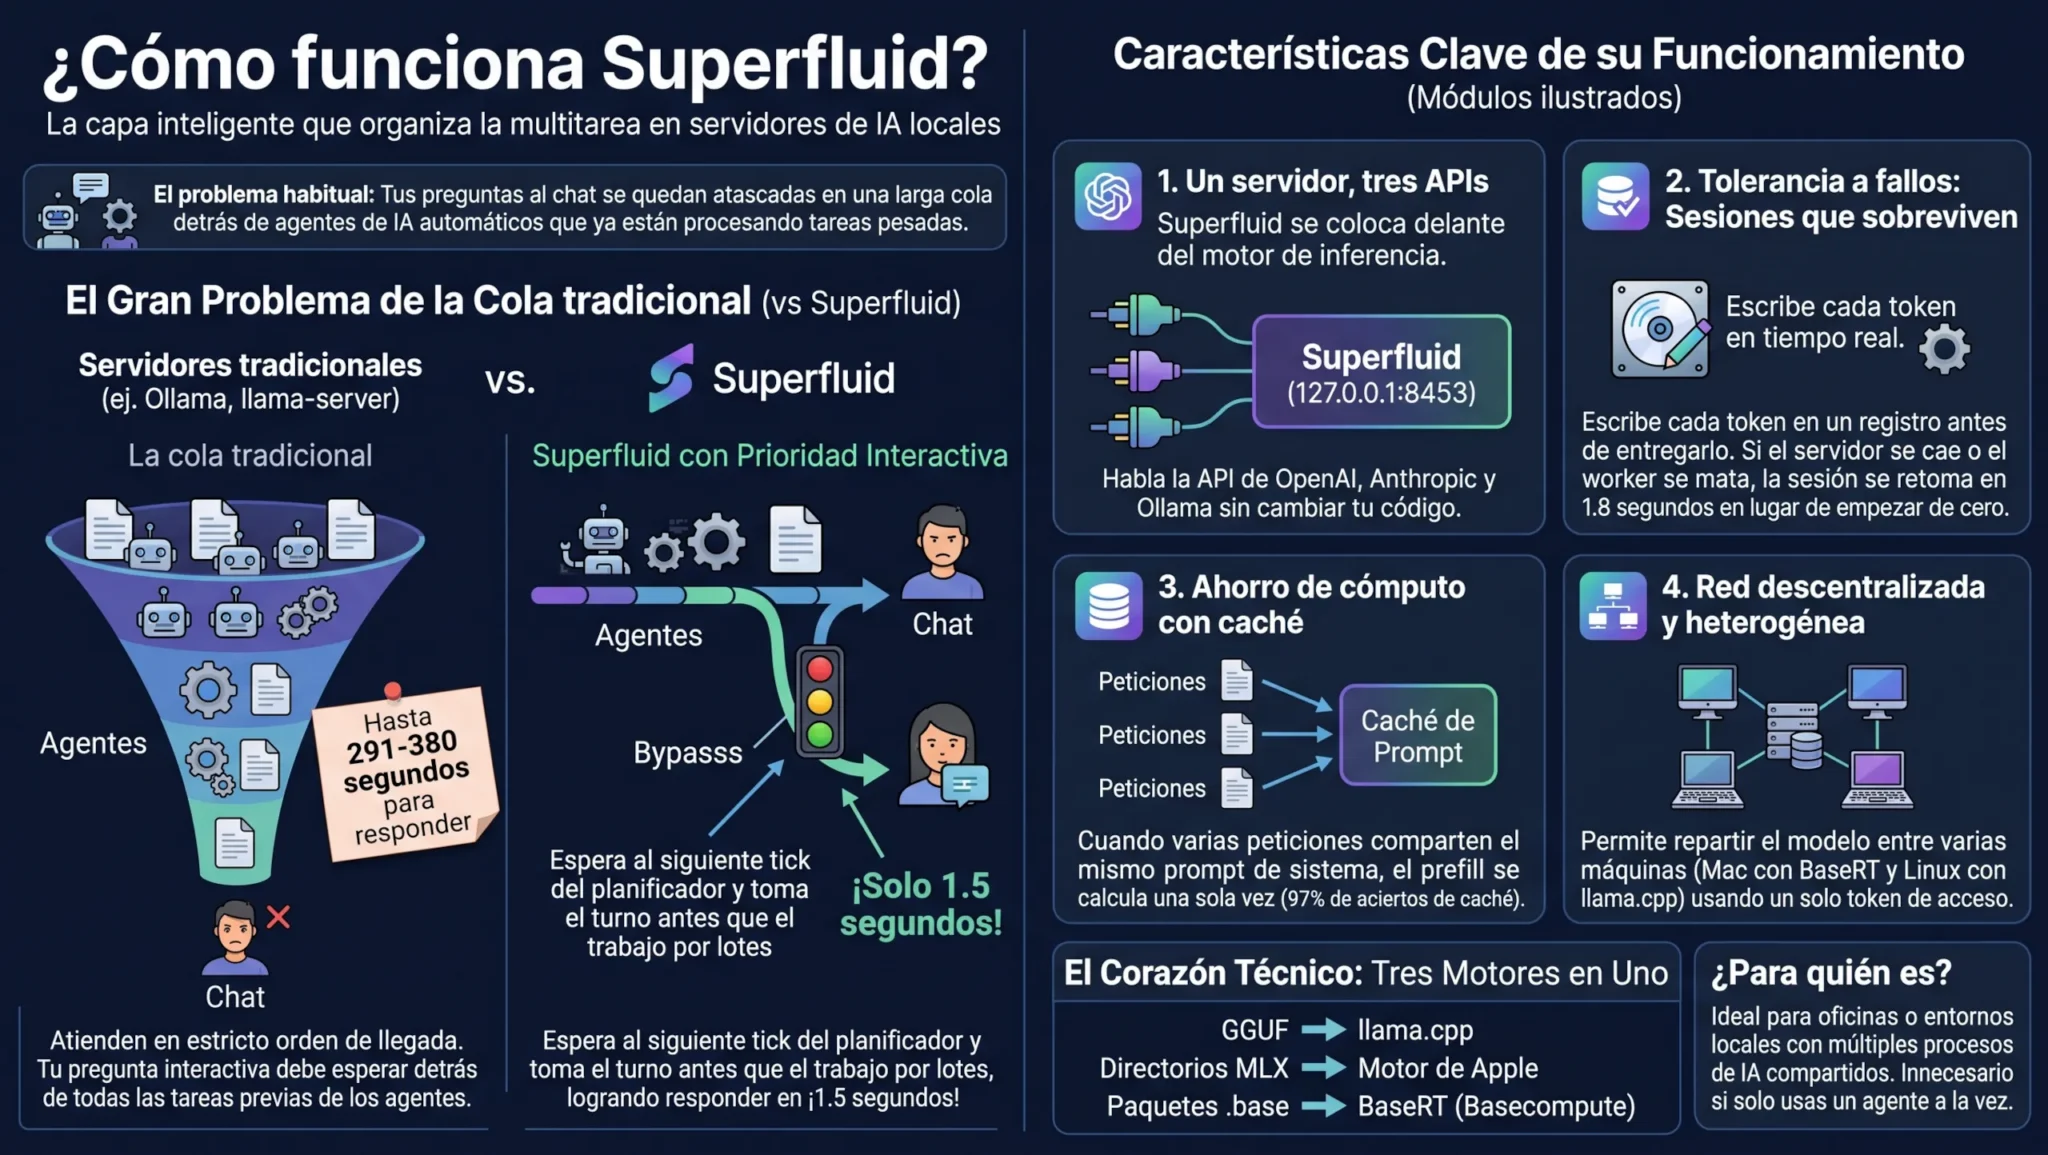
Superfluid se coloca por delante del motor de inferencia y expone tres interfaces distintas sobre el mismo proceso. Habla la API de OpenAI, la de Anthropic y la de Ollama, así que cualquier cliente escrito para cualquiera de las tres funciona apuntándolo a 127.0.0.1:8453 sin tocar una línea de código. La clave de API no se valida, porque el servidor es local.
Por debajo, el motor se elige según el formato del modelo. Los archivos GGUF van a llama.cpp, los directorios de MLX van al motor de Apple y los paquetes .base van a BaseRT, el motor propio de Basecompute.
La ventaja práctica de esa unificación es que el soporte de llamada a herramientas, la salida estructurada y las plantillas de chat son los mismos en los tres casos, algo que no ocurre si se levantan por separado.
Infografía de como funciona Superfluid
El arranque es deliberadamente corto. Un script de instalación con curl para macOS sobre Apple silicon y para Linux en x86-64 y arm64, o cargo install superfluid para quien prefiera compilarlo. En Apple silicon y Linux, el motor BaseRT se instala por defecto, mientras que llama.cpp y MLX se añaden automáticamente cuando el modelo servido los requiere, así que no hay que decidir de antemano qué runtime se va a usar.
Servir un modelo desde el Hub es una línea, y la etiqueta del repositorio elige la cuantización, como en unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M. El mismo comando con un modelo de MLX funciona igual apuntando a un directorio de ese formato. Existe además un comando launch que levanta el servidor si no está corriendo y arranca el agente apuntándolo a él; la lista publicada incluye Claude Code, Codex, pi, OpenCode, Hermes Agent, Cline, OpenClaw y la propia CLI de Ollama, entre otros clientes compatibles.
Sesiones que sobreviven a un cierre
La segunda decisión de diseño del proyecto es menos visible y probablemente más útil a diario. Superfluid escribe cada token en un registro antes de entregarlo al cliente. Si el worker se cae o el servidor se reinicia, la sesión se retoma donde estaba en lugar de empezar de cero. En una ejecución larga de un agente que lleva veinte minutos trabajando, eso evita repetir todo el trabajo previo.
Hay un tercer mecanismo que ahorra cómputo de forma menos obvia. Cuando varias peticiones comparten el mismo prompt de sistema, el prefill se calcula una sola vez. En el escenario medido, 32 peticiones con un prompt de 4.000 tokens compartido dieron un 97% de aciertos de caché frente al 75% de llama-server y el 0% de mlx_lm.server. Ollama también alcanza el 97% en esa fila, y es el único apartado de la tabla donde no hay diferencia apreciable.
El cuarto mecanismo responde a un escenario que crece en popularidad: repartir el modelo entre varias máquinas. Una es la cabecera, expone un puerto para nodos invitados y genera un token; las demás se unen con ese token y descargan el modelo por su cuenta. La cabecera coloca sesiones completas en los nodos y solo recibe los tokens ya muestreados, así que el tráfico entre máquinas es pequeño comparado con mover activaciones. El enlace va cifrado con el token y, si un nodo muere a mitad de stream, su sesión se reasigna sin duplicar tokens.
Los nodos pueden usar motores distintos para el mismo modelo. El ejemplo que da el anuncio es un Mac ejecutando BaseRT junto a una máquina Linux con llama.cpp, sirviendo los dos el mismo modelo bajo la misma sesión lógica. Para un despacho pequeño que tiene hardware heterogéneo, esa mezcla evita tener que unificar la flota antes de empezar.
Lo que la comparativa no dice
El rendimiento declarado tiene tres límites que el anuncio no esconde pero que conviene tener presentes. El primero es que la medición es del fabricante y se hizo en su banco de pruebas, aunque la metodología y las cifras completas estén publicadas en su web. No hay todavía una reproducción independiente con la misma configuración.
El segundo es que la ventaja desaparece cuando no hay contención. El propio anuncio reconoce que, con una o con ocho peticiones concurrentes, llama.cpp servido a través de Superfluid iguala a llama-server en tokens por segundo. La capa de servicio no añade rendimiento por sí misma: lo que añade es orden cuando hay cola.
El tercero es de alcance. La comparativa mide latencia y recuperación, no calidad de resultado ni consumo de energía. Tampoco entra en cuánto ocupa el servidor en memoria, un dato relevante cuando el objetivo es compartir un equipo con ocho agentes y seguir usando el ordenador para trabajar.
¿Quién necesita una cola con prioridades?
La pregunta que deja abierta Superfluid no es si el software funciona, si no cuánta gente tiene hoy el problema que resuelve. Un usuario con un solo agente y una sola pregunta no necesita reparto justo: necesita que el modelo responda, y para eso llama-server o Ollama bastan. La situación cambia cuando el equipo pasa a ser un recurso compartido entre procesos que no saben nada los unos de los otros.
Ahí es donde el proyecto se vuelve interesante y también donde aparece su riesgo. Cuanta más lógica de reparto se añade entre el cliente y el modelo, más piezas pueden fallar de forma silenciosa. La apuesta de Basecompute es que el registro previo de cada token compensa esa complejidad, y que la prioridad interactiva es una función de sistema operativo más que una comodidad.
Para quien lleva tiempo montando modelos locales en casa o en una oficina pequeña, la propuesta es fácil de evaluar: si alguna vez has visto tu propia pregunta esperar detrás de un proceso programado, el problema es real y este es un intento razonado de resolverlo. Si nunca te ha pasado, no hay nada que ganar instalándolo todavía.