Parsimony, el software que mide cuánto código añade la IA
Parsimony, el benchmark abierto con licencia MIT, cuenta en unidades de sintaxis lo que añade cada agente de IA y revela brechas del 43% entre modelos.
Parsimony, el software que mide cuánto código añade la IA
Un desarrollador que firma como lasu presentó el 13 de octubre de 2026 en Hacker NeNanomuse, el agente de IA open source que corre en móvil y PCws una idea sencilla e incómoda: medir cuánto código escribe un agente de inteligencia artificial para resolver un problema, y no solo si lo resuelve. El proyecto se llama Parsimony, tiene licencia MIT y promete cambiar por completo el benchmarking de IA. En su tablero principal, Claude Fable 5 añadió 0,80 veces el código que sumaron los demás modelos en las mismas tareas resueltas, mientras Claude Opus 5 subió a 1,14 veces con idéntico porcentaje de éxito.
El hueco que cubre es real. Los benchmarks actuales responden a dos preguntas, si el modelo arregla la tarea y cuánto cuesta en tokens, y ninguna castiga el exceso de código. Para quien mantiene un repositorio durante años, ese exceso es un coste de revisión que se paga en cada lectura. Parsimony no ejecuta nada ni vuelve a pasar los tests, y su código está en github.com/La5u/Parsimony.
Que un parche sea más pequeño no significa que sea mejor, porque la medida cuenta tamaño y anidamiento, y no legibilidad ni diseño. Los modelos que escriben más código tienden también a resolver más tareas, con una correlación de Spearman de 0,33 a 0,60 en los tableros grandes.
¿Qué hueco dejan los benchmarks de código?
Los benchmarks que dominan la conversación se construyen sobre una pregunta binaria: la tarea se resuelve o no se resuelve. SWE-bench Verified reúne 500 incidencias reales de proyectos libres y pública para cada intento el parche del agente junto al resultado de las pruebas.
DeepSWE, aparecido en 2026, plantea tareas más largas sobre repositorios activos y también publica los parches finales. El coste se mide en tokens, nunca en el tamaño del cambio, y ese es el hueco que Parsimony ocupa. En Observatorio hemos seguido el terreno de los agentes que escriben software, como en el caso de la seguridad de los agentes de NVIDIA.
Parsimony aprovecha ese material en lugar de generar el suyo. No llama a ningún modelo ni ejecuta código: aplica sobre la base de cada tarea los parches ya publicados y parsea el antes y el después. La pregunta que añade es cuánto pesa el arreglo en elementos de sintaxis, una cifra que no existía en ninguna clasificación pública.
¿Cómo se mide una unidad de código?
El analizador no cuenta líneas. Cada lado del parche se convierte en un árbol de sintaxis y de ahí se extraen unidades: un enunciado, una llamada o una comparación, además de cada nombre y cada literal. Como la medida es sintáctica, comprimir el código en menos líneas no mejora la nota. Y como cada bloque cierra con una unidad propia, mover código entre niveles de anidamiento también se paga. Los comentarios, el formato y la longitud de los nombres quedan fuera.
El ejemplo que el propio repositorio usa para explicarse es un bucle que se sustituye por la función `sum()`. El recuento da 13 unidades eliminadas y 3 añadidas, así que el resultado neto baja en diez unidades. Esa resta importa: el número final es lo añadido menos lo eliminado, de modo que un parche que borra más de lo que escribe puede terminar en negativo.
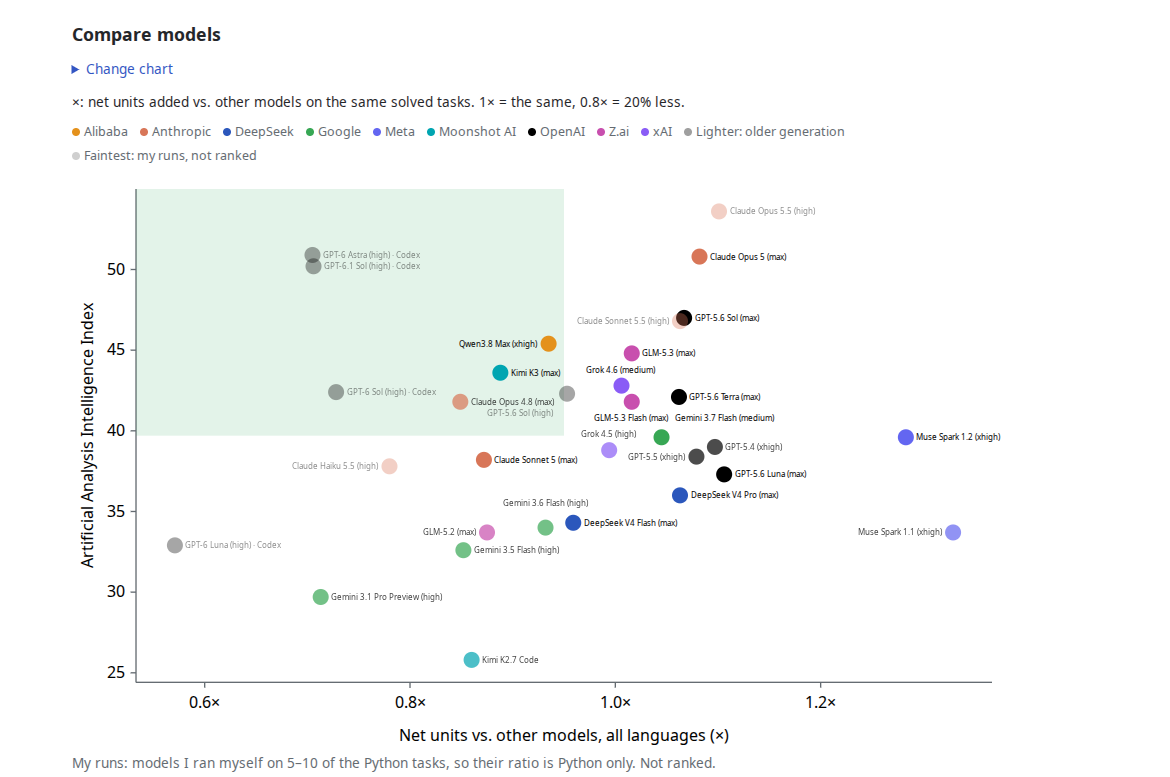
Un vistazo al bench de Parsimony en su web oficial
El alcance se acota a los ficheros de implementación en Python: pruebas, documentación y generados quedan fuera, y hay tableros separados para JavaScript, TypeScript, Go y PHP. El analizador de Python no necesita dependencias y funciona desde la 3.12, así que cualquiera puede recalcular una muestra en su máquina.
La clasificación tampoco es una media simple. Para cada modelo se parte de las unidades netas que añadió en las tareas que resolvió y se divide por lo que añadieron los demás en esas mismas tareas, de forma que un 0,80 significa un 20% menos de código. Solo cuentan las tareas que resolvieron al menos otros tres modelos, así que un sistema que únicamente acierta las fáciles no parece austero por defecto.
¿Qué dicen los números del tablero principal?
El tablero principal son 26 modelos sobre 34 tareas de DeepSWE en Python, con cuatro intentos por tarea. El primer puesto es un espejismo estadístico: Gemini 3.1 Pro Preview aparece con 0,66 veces el código de sus rivales, pero solo resolvió el 8,1% de los intentos.
Puesto
Modelo
Código frente a los demás
Resueltas
2
Claude Fable 5
0,80×
74,3%
3
Claude Sonnet 5
0,83×
59,6%
4
Claude Opus 4.8
0,84×
63,2%
18
GPT-5.6 Sol
1,06×
74,3%
24
Claude Opus 5
1,14×
74,3%
26
Muse Spark 1.1
1,35×
52,9%
Claude Fable 5 y Claude Opus 5 resolvieron el mismo 74,3% de los intentos, y sin embargo el primero añadió 0,80 veces el código de la media y el segundo 1,14 veces. La brecha entre dos modelos que aciertan lo mismo ronda el 43%. En unidades netas, Fable 5 sumó 1.557,5 de media en los intentos resueltos y Opus 5 llegó a 2.183,4.
El segundo tablero, sobre las 500 tareas de SWE-bench Verified, cambia el orden: Qwen2.5-Coder 32B queda primero con 0,41 veces el código de sus pares, aunque solo resolvió el 9%. Gemini 2.5 Pro baja hasta 0,54 y Claude Opus 4.5 se queda en 0,67 con un 76,8% de aciertos. La lectura útil, más que el podio, es la dispersión de fondo: entre el modelo más austero y el más verboso la diferencia supera el doble, y ninguna de las dos posiciones significa que el código sea mejor.
¿Qué admite el propio benchmark?
El repositorio incluye una validación propia con casos diseñados para mover la métrica cuando debe moverse y dejarla quieta cuando no. La batería encontró dos fallos, corregidos en la versión 0.5.1, y el autor publica también las trampas que siguen abiertas sin maquillarlas.
La primera trampa es de fondo. Borrar una función que nadie usa resta unidades y mejora la puntuación, aunque esa función no tenga nada que ver con el fallo. Intercambiar dos funciones cuesta ocho unidades pese a que el archivo hace lo mismo. Y escribir un caso especial para la entrada del test cuesta 12 unidades, mientras la solución general cuesta 14, así que la métrica premia la trampa por dos unidades.
El arnés también pesa en el resultado. En los tableros de DeepSWE y de Verified casi todas las filas se generaron con el mismo agente, mini-SWE-agent, y eso hace comparables los modelos entre sí, pero no aísla al modelo del entorno que lo ejecuta. La excepción es GLM-5.1 en Verified, que llega desde una exportación de un tercero con otro agente distinto, y el propio proyecto avisa de que esa fila no es una comparación controlada.
¿Quién ha reproducido las cifras?
La pregunta que cualquier lector debería hacerse es si alguien ajeno al proyecto ha vuelto a calcular estas cifras. A 16 de octubre de 2026, la respuesta es que no consta. El repositorio se creó el 21 de septiembre y acumula más de 150 confirmaciones en la rama principal, con una decena de estrellas y dos bifurcaciones. No hay auditoría externa ni réplica publicada de la clasificación, y conviene decirlo antes de citar cualquier puesto del tablero como si fuera un resultado asentado.
El diseño está pensado para que una réplica sea posible, no para que ya exista. Cada registro guarda la huella criptográfica del parche y de los resultados de los que salió, el commit base de la tarea, la versión del analizador y la versión de Python empleada. Como no se ejecuta código, repetir el cálculo no exige GPU ni claves de API, solo los mismos artefactos.
Hay una señal que conviene mirar con lupa. El autor reejecutó GPT-5.6 Sol por su cuenta en un arnés distinto, con pocas tareas y autoevaluación, y esa ejecución añadió 0,88 veces el código de la ejecución oficial del mismo modelo. Son doce puntos de diferencia atribuibles al entorno y no al modelo. Esas filas propias aparecen atenuadas en la web, no llevan etiqueta de verificación y no entran en la clasificación.
Un coste de revisión, no una nota de calidad
Lo más honesto que tiene Parsimony es que no pretende ser un ranking de calidad. Un parche pequeño puede ser críptico, incompleto fuera de los tests que lo validan o directamente inseguro, y el propio proyecto lo dice por escrito. Lo que ofrece es una señal de coste: si dos agentes resuelven lo mismo y uno escribe la mitad, el revisor humano lee la mitad y el repositorio acumula menos superficie que mantener.
Para un equipo que paga por tokens y por revisiones, la cifra tiene valor práctico si se calcula en casa. Antes de fiarse de un tablero ajeno conviene medir en el propio repositorio el tamaño neto de los cambios aceptados, separados por modelo, porque el arnés y la selección de tareas mueven el resultado. En un terreno donde las cifras se repiten sin fuente y sin fecha, comprobar de dónde sale cada número sigue siendo la parte del trabajo que ninguna herramienta automatiza.